경찰과 도둑 앱 LLM 지표 챗봇의 숫자를 코드로 계산하기
지표 화면 앞에서 멈춘 팀원들
위치를 공유하며 뛰는 술래잡기 앱 "경찰과 도둑"을 만들고 있다. 10월 초에는 팀만 들어가는 관리 화면(어드민)에 지표 화면을 만들었다. 인스타그램, 구글 애널리틱스(GA4), 앱스토어와 구글 플레이, 게임 서버에 흩어져 있던 숫자를 한곳에 모았다.
그런데 다 만들고 보니 나한테만 편한 화면이었다. 나는 숫자를 보다 궁금한 게 생기면 평소 쓰던 AI 코딩 도구에 바로 물어보면 됐다. 다른 팀원들은 달랐다. 숫자를 보다 '이건 왜 이렇지?' 싶어도 물어볼 데가 없었다.
우리 팀에는 디자이너도, 백엔드 개발자도, 마케터도 있다. 궁금한 것도 저마다 다르고 지표 읽는 법을 모두 아는 것도 아닌데, 화면은 미리 정해 둔 질문에만 답해 줬다.
처음에는 돈이 안 드는 방법을 생각했다. 지표를 복사해서 다른 AI에 붙여 넣게 하는 버튼이었는데, 별로였다. 그래서 결국 어드민 안에서 질문에 답할 AI 모델을 직접 연결하기로 했다. 비용은 구글 AI Pro 구독에 딸린 클라우드 크레딧 안에서 해결하기로 했다.
모델에게 맡기지 않은 숫자
가장 걱정됐던 건 모델이 그럴듯하게 지어낸 숫자였다. 지표를 모르는 사람은 그 숫자가 틀렸는지 알아채기 어려울 것 같았다. 그래서 모델이 할 일부터 줄였다.
지난주, 이번 달 같은 말을 날짜로 바꾸는 일도, 증감 계산도 코드가 맡았다. 데이터도 지표 화면과 같은 계산을 거치는 조회 함수로만 읽게 했다.
비슷한 사례를 찾아보다가 dbt Labs의 실험을 봤다. 모델에게 데이터를 꺼내는 명령문(SQL)을 직접 짜게 하는 방식과, 지표 정의를 고정해 두고 읽게 하는 방식을 비교한 실험이었다. 정의를 고정한 쪽이 더 정확했고, 틀릴 때 모습도 달랐다.
SQL을 짜게 하면 그럴듯한 오답을 냈고, 정의를 고정해 두면 모르는 건 모른다고 하고 답을 내지 않았다. 방향을 정할 때 이 실험을 참고했다.
답은 사실과 가설로 나눠 받았다. 사실 문장의 숫자는 코드가 조회 결과와 대조하고, 안 맞으면 한 번 다시 쓰게 했다. 그래도 안 맞으면 숨기지 않고 화면에 "숫자를 확인하지 못했어요"라고 띄웠다.
원인도 단정하지 못하게 했다. 같이 움직인 숫자만 주고 원인을 고르라고 하면 모델이 거의 찍는 수준이라는 연구(Corr2Cause)가 있었기 때문이다. 그래서 사실 문장에서는 원인을 말하지 못하게 하고, 원인은 가설 칸에만 적게 했다.
숫자는 맞는데 이상한 답
첫 평가에서는 실제 서비스(운영)와 같은 경로로 실제 모델에 질문 28개를 보내고 채점했다. 결과는 25개 통과였고, 통과하지 못한 셋도 채점 기준을 잘못 잡아서 떨어진 것이었다. 숫자는 모두 조회 결과와 맞았다. 그런데 답을 하나씩 읽어 보니, 숫자가 맞아도 질문에 제대로 답하지 못한 경우가 있었다.
행사 질문부터 그랬다. 같은 날 반포한강공원의 서대페와 어린이대공원의 청춘대로, 두 행사에서 게임을 열었는데 챗봇은 둘을 나눌 수 없다고만 했다. 어느 게임이 어느 행사 것인지는 어드민 달력에 이미 표시해 두었는데, 챗봇은 그 정보를 모르고 있었다.
참가 인원도 판마다 더한 연인원 103명으로 말했다. 여러 판에 나온 사람은 한 번만 세야 했고, 그렇게 세면 59명이었다. 이번 주 6일과 지난주 7일을 그대로 비교해서 다 줄었다고 한 답도 있었고, 답 중간에 event_window 같은 영어 이름이 섞여 나오기도 했다.
그래서 행사 성적표 도구를 따로 만들고, 같은 사람은 겹치지 않게 세고, 비교할 때는 날 수를 맞췄다. 문항을 29개로 늘려 다시 돌리니 모두 통과했다. 그 뒤로 챗봇은 "서대페 실제 방문객 59명, 청춘대로 5명"처럼 나눠서 답했다.
걷어 낸 화면과 체다라는 이름
처음 만든 채팅 화면에는 가운데 큰 그림과 제목, 선으로 나눈 목록, 아이콘을 단 머리말이 있었다. 보고 있으니 AI가 만든 화면 같았다. 그래서 모두 걷어 내고 말풍선과 둥근 버튼만 남겼다.
지표 화면은 요약, 인스타그램, 스토어처럼 탭으로 나뉘어 있다. 처음에는 챗봇이 열린 탭을 기준으로 답했다. 화면에서 고른 기간을 기준으로 답해야 한다고 내가 짚어서 바꿨다.
챗봇 이름은 체다로 지었다. 우리 세계관에서 경찰 팀 캐릭터 냥파는 특수치즈수사대, 도둑 팀 캐릭터 도둥이는 반치즈주의자다. 그 사이에 서는 치즈 캐릭터가 어울릴 것 같았다.
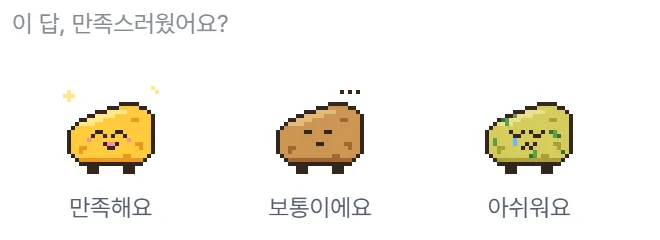
답이 마음에 들었는지는 엄지 대신 치즈 신선도로 받는다. 노란 치즈, 갈색 치즈, 곰팡이 핀 초록 치즈다. 처음에는 글자도 "신선해요, 상했어요"였는데, 처음 보는 사람에게는 와닿지 않아서 글자는 만족도를 묻는 말로 바꿨다.
숫자를 뺀 말풍선
화면에서 실제로 받아 본 답은 이랬다.
App Store 최초 다운로드는 88건에서 161건으로 73건(83%) 늘었고, Google Play 최초 설치는 115명에서…
틀린 숫자는 없었다. 하지만 한 문장에 네 개씩 들어가 있으니 잘 읽히지 않았다. 숫자를 조회 결과와 대조하는 검증기는 결과에 없는 숫자는 막아 줬지만, 숫자를 늘어놓는 답까지 막아 주지는 못했다.
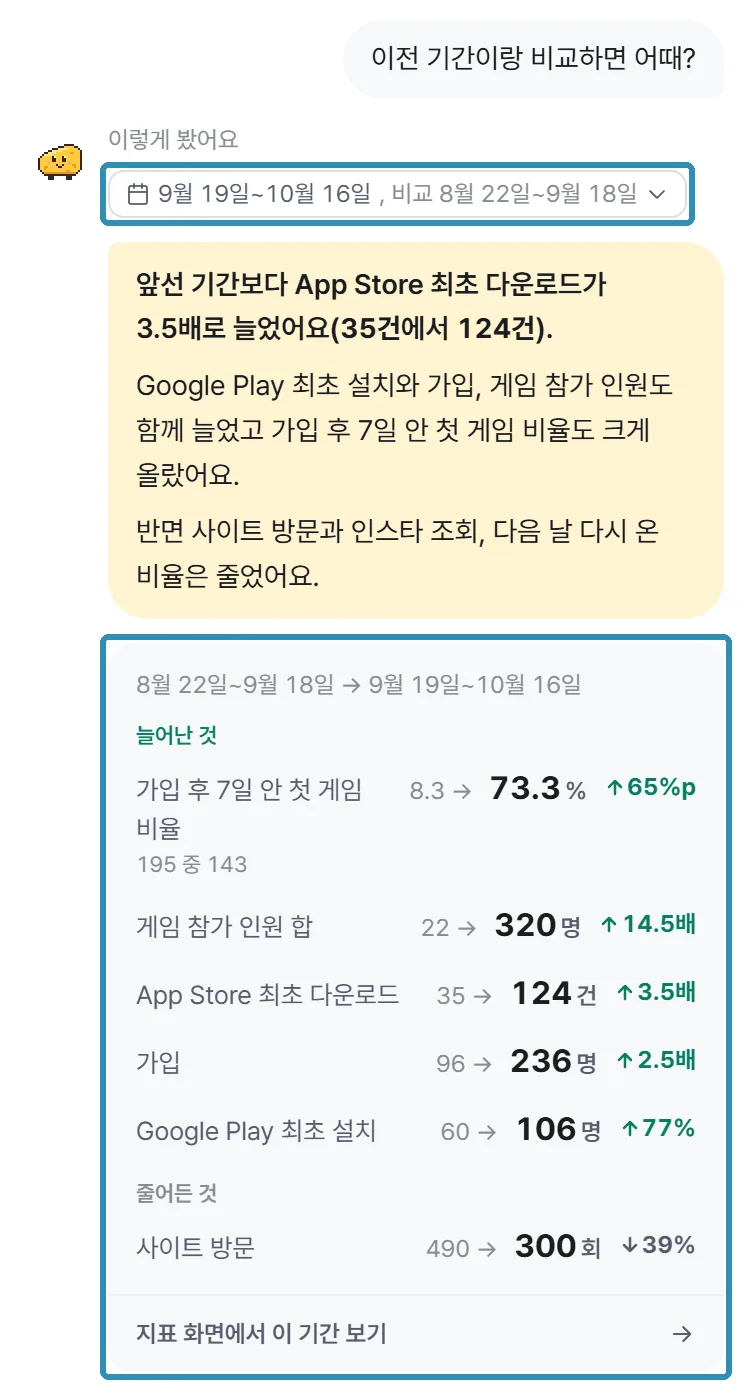
그래서 이번에도 내가 방향을 정해, 숫자 대부분을 모델이 쓰지 않게 바꿨다. 모델은 카드로 보여 줄 지표의 이름만 고르고, 화면에서는 조회 결과의 숫자를 바로 가져와 카드로 보여 주게 했다.
말풍선에는 결론 한 문장과 숫자 없는 짧은 해석만 남겼고, 결론에 쓰는 숫자도 전후 한 쌍까지로 줄였다. 이렇게 바꾸니 카드의 숫자는 모델이 옮겨 쓰다 틀릴 일이 없어졌다.
체다가 실제로 본 기간과 행사도 답 위에 누를 수 있는 작은 꼬리표(칩)로 띄웠다. 지표를 모르는 사람도 무엇을 보고 한 답인지 알 수 있고, 체다가 질문을 잘못 알아들었으면 칩을 눌러 기간만 바꿔 다시 물을 수 있게 했다.
손대지 않은 질문으로 다시 재기
고치고 나면 늘 같은 의문이 남았다. 정말 나아진 건지, 매번 보던 질문에만 맞춘 건지.
그래서 질문을 두 묶음으로 나눴다. 하나는 그동안 보면서 고쳐 온 질문 29개(골든 질문), 다른 하나는 새로 써 두고 고치는 데는 한 번도 쓰지 않은 질문 10개(홀드아웃 질문)다. 모델 답은 매번 조금씩 달라서, 같은 질문을 세 번씩 돌렸다.
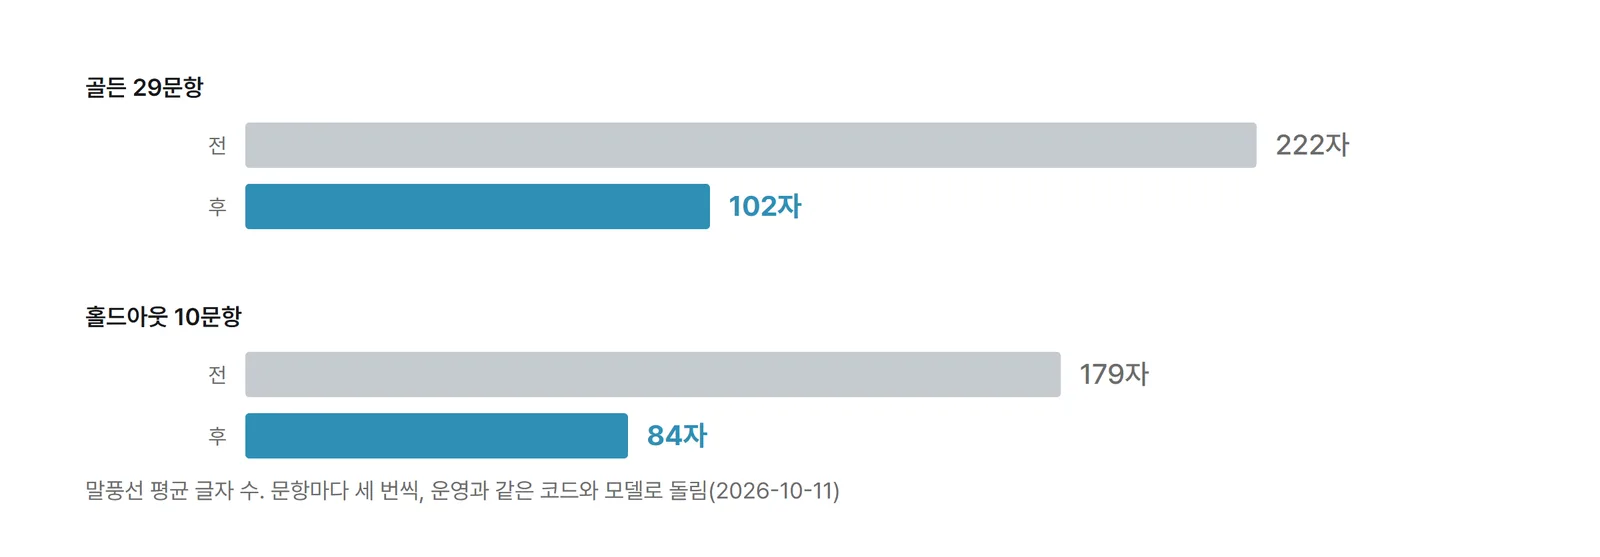
말풍선 평균 길이는 골든 질문에서 222자에서 102자로 줄었다. 손대지 않은 홀드아웃에서도 179자에서 84자로 줄어서, 골든에만 맞춘 건 아닌 것 같았다. 문장당 숫자는 골든 평균 2.0개에서 1.1개가 됐다.
답을 기다리는 시간에도 상한을 정해 두었다. 첫 단계가 38초를 넘으면 끊고, 그때까지 받은 조회 결과로 마무리하게 했다. 가장 느린 답은 63.7초에서 42.5초로 줄었다. 63.7초는 서버의 60초 한도를 넘는 시간이라, 운영이었다면 답 대신 오류가 났을 것이다.
하지만 매번 통과하던 골든 문항은 29개에서 27개로 줄었다. 하나는 실제로는 숫자가 늘어난 기간을 두고 "이 기간 왜 이렇게 떨어짐?"이라고 묻는 문항이었다. 체다는 전제만 바로잡고 이유 후보를 비워 버렸다.
그 기간에도 줄어든 지표는 있었으니 이유 후보는 있어야 했다. 그래서 지시문에 한 줄을 더하고 그 문항만 다시 돌려 통과시켰다.
다른 하나는 117번 중 한 번 모델이 빈 응답을 돌려준 경우였다. 코드는 응답을 담는 JSON 형식이 깨졌을 때만 잡고 있어서 빈 응답은 그대로 오류가 됐다. 그래서 빈 응답이 와도 그때까지 모은 조회 결과로 마무리하게 고쳤다.
맞는 문장을 틀렸다고 한 검사기
평가에 쓰는 검사기 중에는 숫자가 조회 결과에 있더라도 다른 지표의 값을 가져다 썼는지 가려내는 검사가 있다. 그런데 이 검사가 추석 질문의 답을 틀렸다고 잡았다.
문장은 "참가 인원은 연인원 15명"이었고, 지표의 실제 이름은 게임 참가 인원 합이었다. 이름이 통째로 문장에 없자, 검사기는 하필 값이 똑같이 15인 하루 활성 사용자 평균을 가져다 썼다고 봤다.
사람이 읽으면 맞는 문장이었지만, 15처럼 작은 값은 다른 지표와 겹치기 쉬웠다. 그래서 지표 이름의 낱말이 둘 이상 문장에 있으면 그 지표의 값으로 보게 검사기를 고쳤다. 이전 결과도 고친 검사기로 다시 채점했다.
지출 한도 절반을 쓴 평가 실험
어느 날 구글 클라우드에서 메일이 왔다. 걸어 둔 지출 한도 12,000원의 절반을 썼다는 알림이었다. 같은 날 어드민 화면은 "이번 달 약 598번 더 물어볼 수 있어요"라고 하고 있었다. 둘이 전혀 다른 말을 하고 있어서 꽤 놀랐다.
확인해 보니 지출 한도는 크레딧을 빼기 전 정가로 계산하는 거라, 실제로 나간 돈은 없었다. 남은 횟수를 계산할 때는 질문 기록만 세고 있어서 평가 실험에 쓴 돈이 빠져 있었는데, 그날 실험만 답 323개, 4.12달러어치였다.
그래서 실험 비용을 따로 쌓는 데이터베이스의 표(테이블)를 만들고, 남은 횟수는 질문 기록과 실험 비용 두 테이블을 합쳐 세게 바꿨다. 어드민별, 버전별 성적이 부풀까 봐 질문 기록에는 섞지 않았다.
전체 평가는 돌릴 때마다 1.5달러쯤 든다. 그래서 그 뒤로는 바뀐 부분과 관련된 문항만 돌리고, 전체는 버전을 낼 때만 돌리기로 했다.
체다 1.0
처음 지표 화면을 만들었을 때, 나는 궁금한 것을 물어볼 수 있었지만 다른 팀원들은 화면 앞에서 멈췄다. 이제는 같은 어드민 안에서 체다에게 질문하고 답을 받을 수 있다.
팀원들이 실제로 무엇을 물을지는 아직 모르고, 답이 어땠는지는 신선도 평가가 모이면 살펴볼 생각이다. 체다 1.0으로, 미리 정해 둔 질문에만 답하던 지표 화면에 팀원들이 자기 질문을 꺼낼 자리가 생겼다.
keep reading
comments
자유롭게 생각을 남겨주세요.